组装了一块 32GB 巨大显卡跑本地大模型
大家好,我是罗孚,一位 AI 爱好者。
今天给大家介绍一下我的 32GB 巨大显卡。
眼见为实的巨大显卡
显卡,32GB,还巨大。没错,真的巨大。不信?你看:
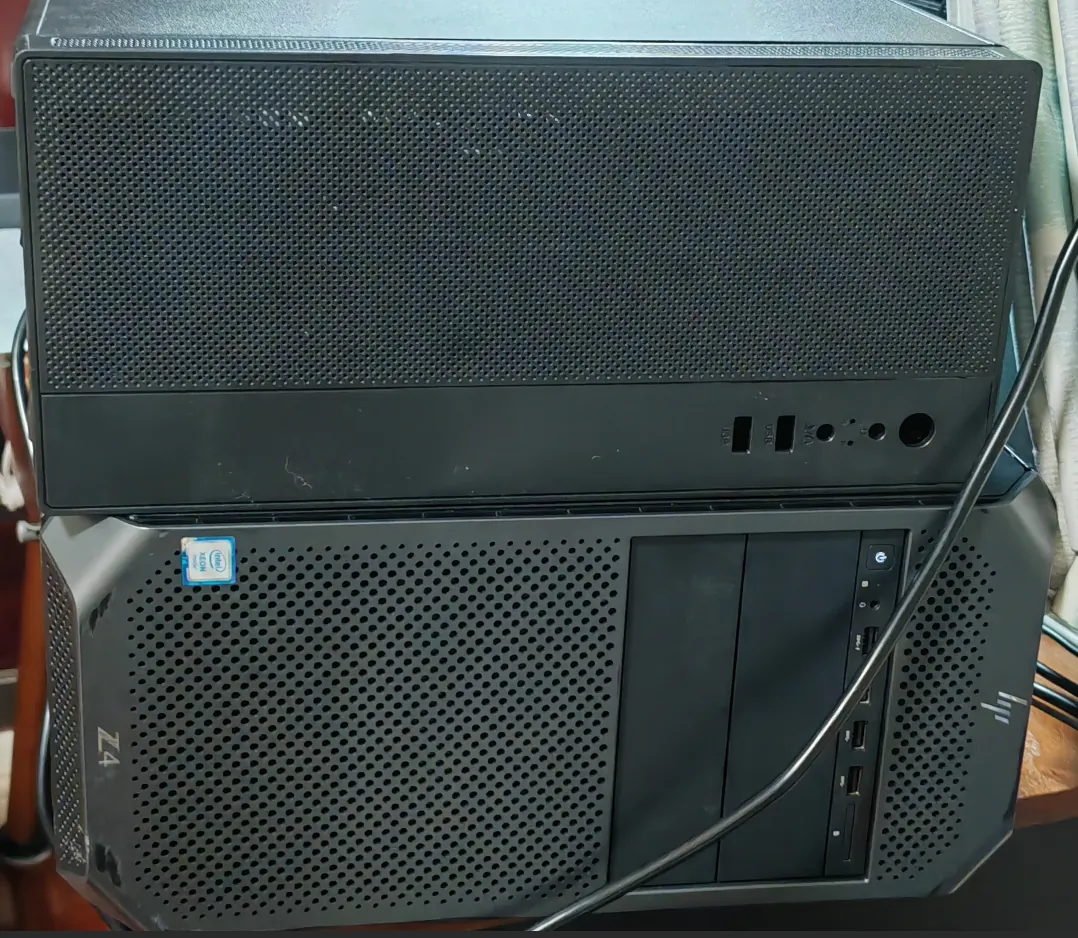
上面是显卡,下面是 HP Z4G4 工作站。它们之间通过 8654 交叉线连接:
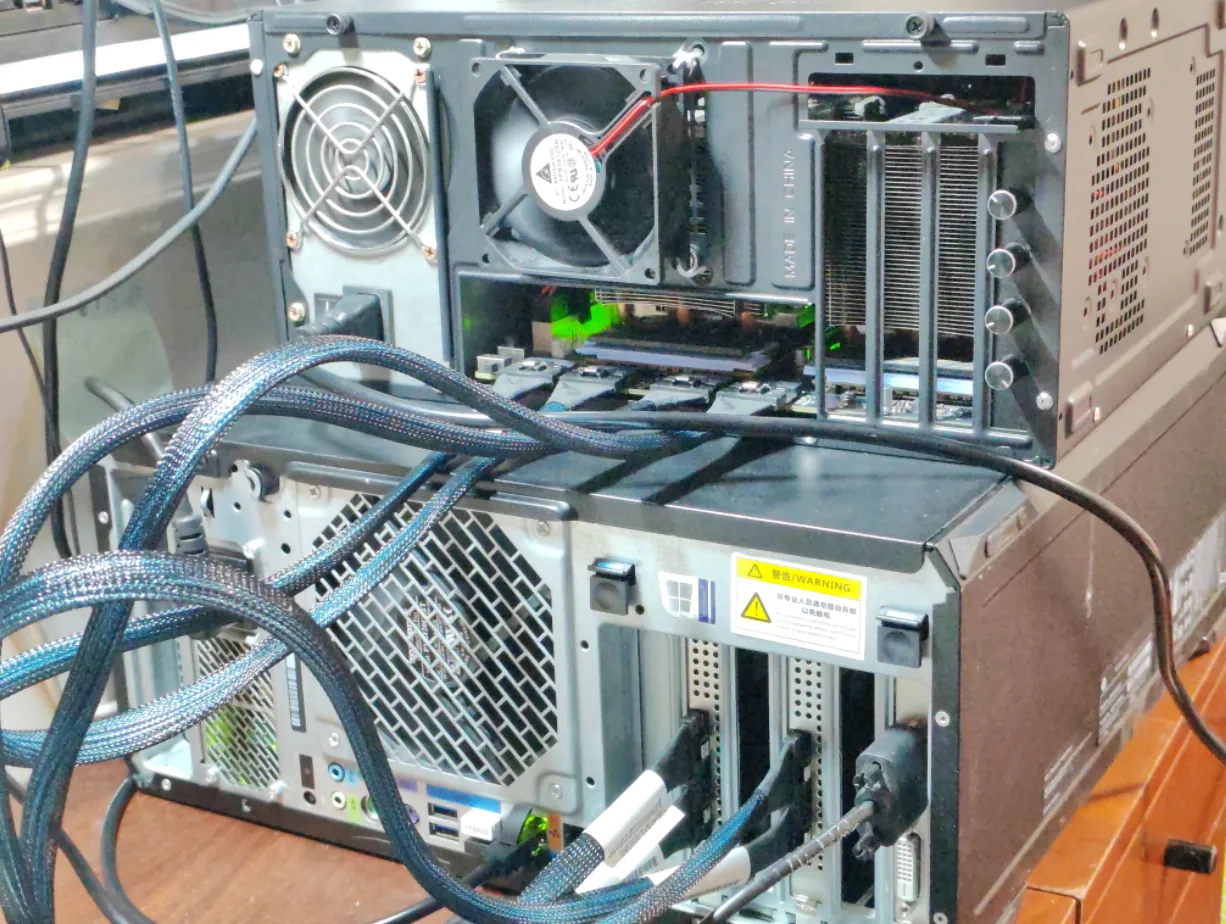
不得不说,尺寸确实相当巨大。完整尺寸如下:
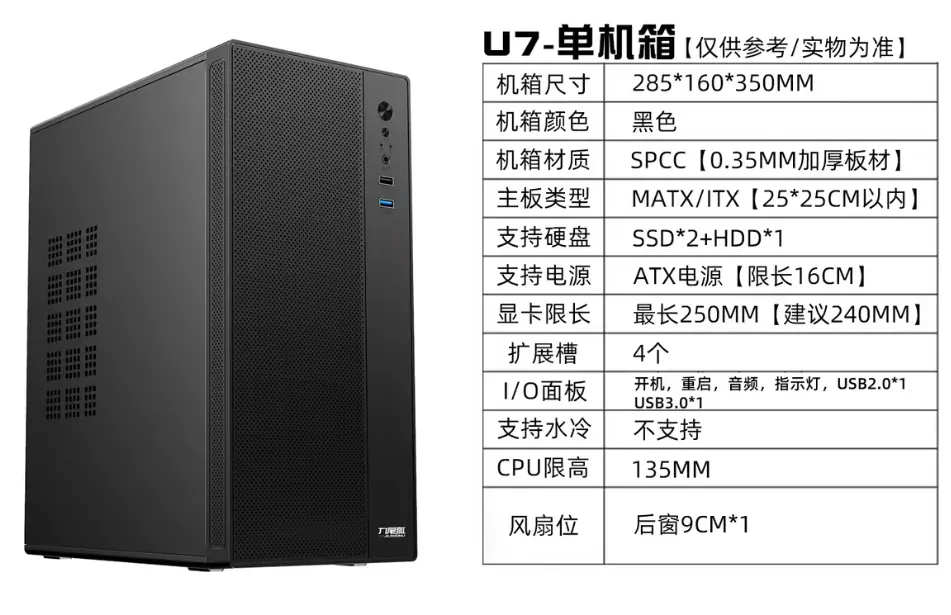
是的,这实际上是一块安装在机箱里的显卡,内部由两块 SXM2 V100 显卡组成。
巨大显卡详细介绍
好吧,下面详细介绍一下这块巨大显卡。
正如前面所说,它实际是由两块 SXM2 版 V100 显卡组成的。
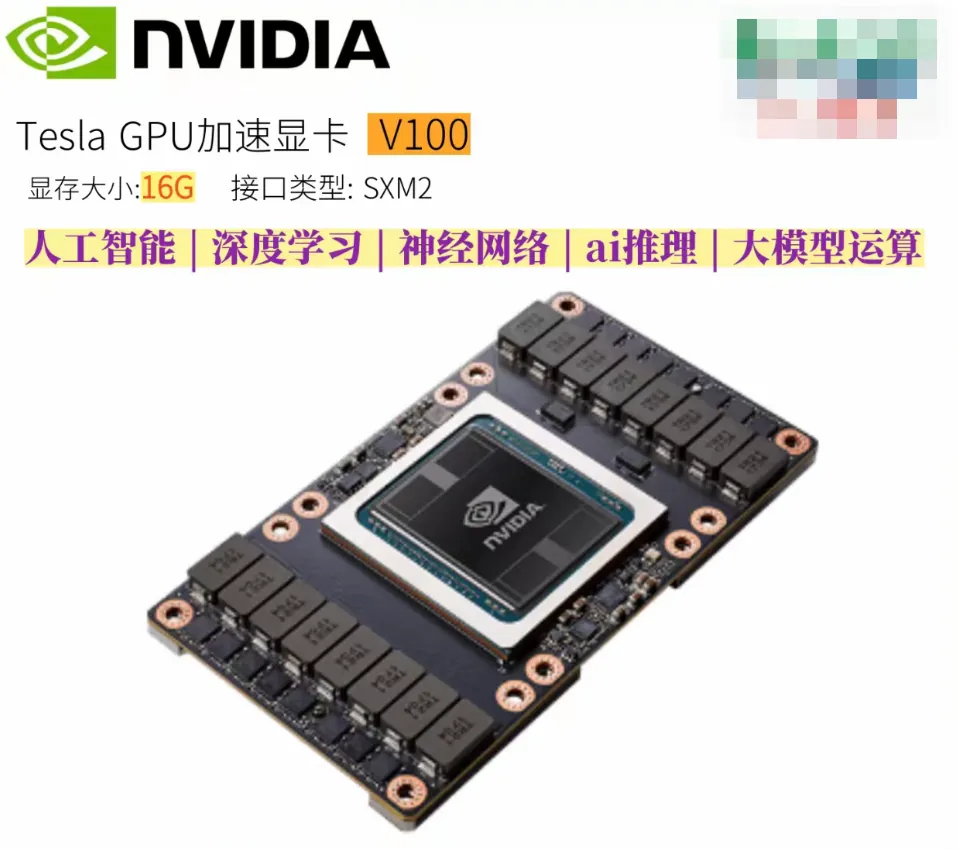
然后再连接到转接底板上:
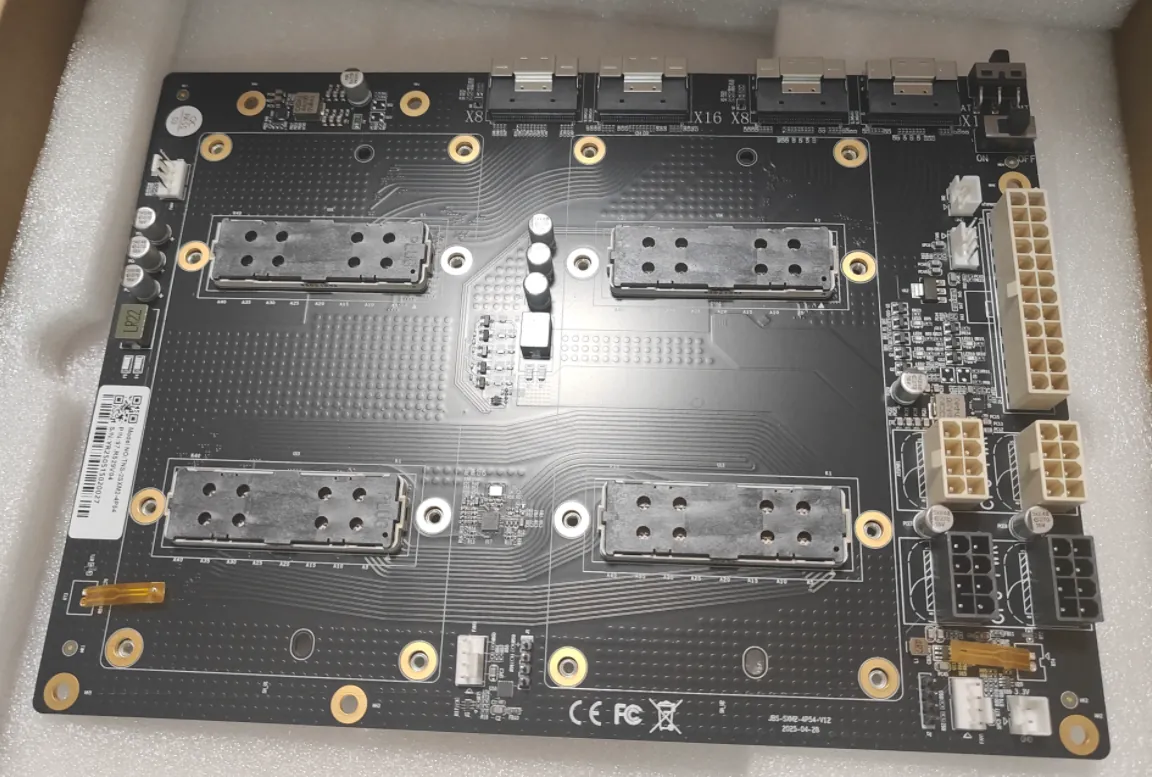
再加上两块 x16 转接卡,就可以组成这块“巨大显卡”了。
它的原理基本就是这样。不过,真正需要购买的东西还比较多:
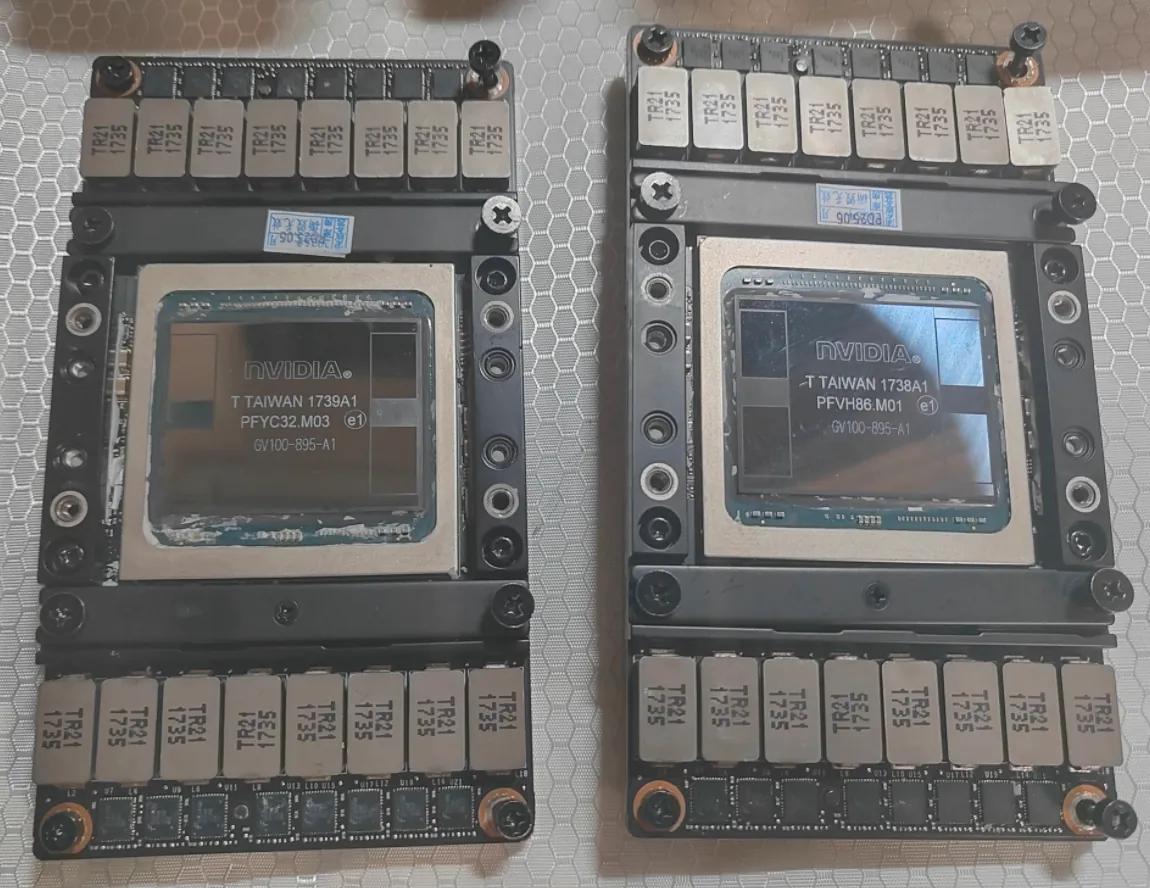
显卡 2 块:NVIDIA Tesla SXM2 版 V100 16GB
转接主板 1 张 + 转接卡 2 块:算是显卡主板
8654 交叉线 4 根:用来连接显卡和主机 PCIe
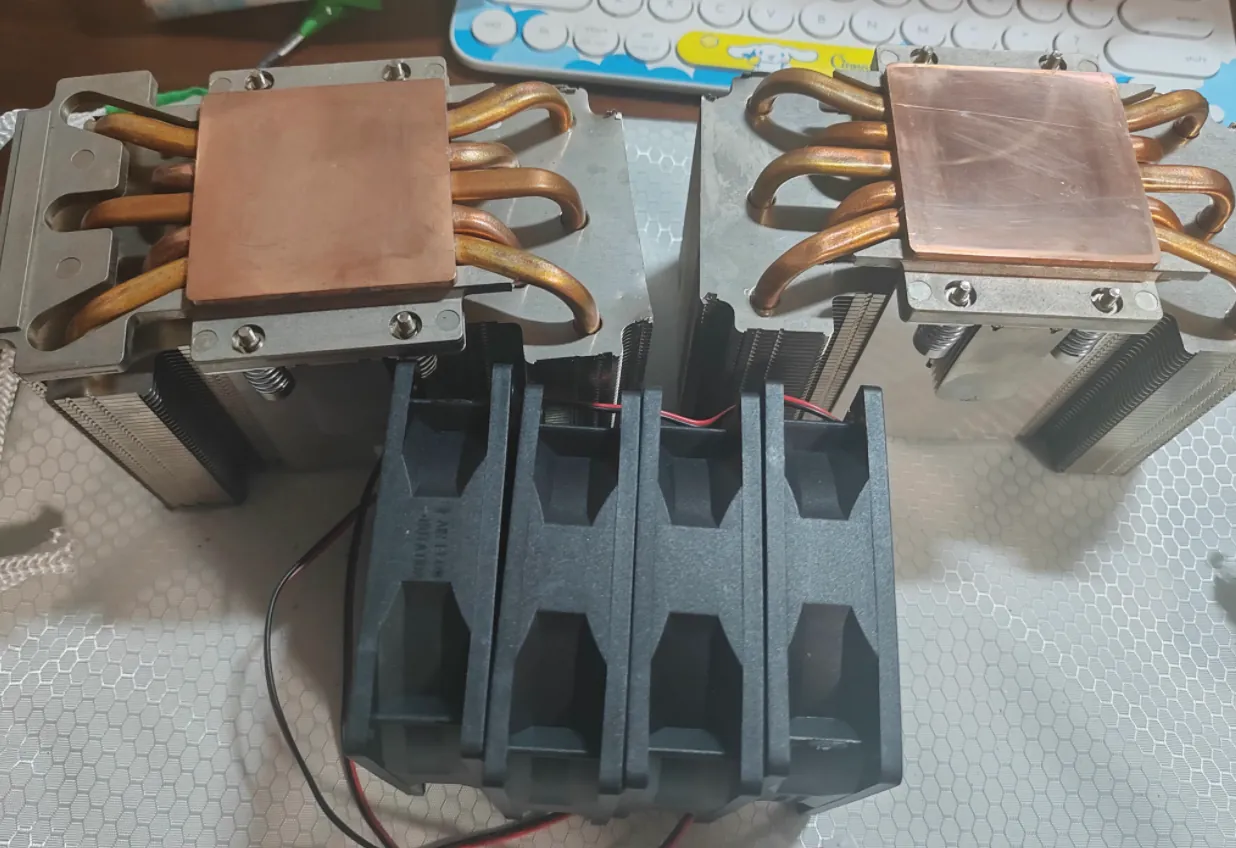
SXM2 原装散热器 2 个:主要散热设备
显卡机箱 1 个:用来安装这块巨大显卡
1850W 电源 1 个:提供充足供电
12×12 小风扇 5 个:用于机箱和显卡周边散热
基本就是这些,准备好之后就可以开始组装了。
散热器和小风扇:
显卡主角:
主板前面已经拍过,机箱、电源等部件在后面的组装过程中都会看到。
动手组装巨大显卡
讲完原理,下面就亲手组装一下这块巨大显卡。
没有专门拍全家福,但上面列出的东西一件都没有少。
第一步:将 SXM2 V100 显卡安装到显卡主板上
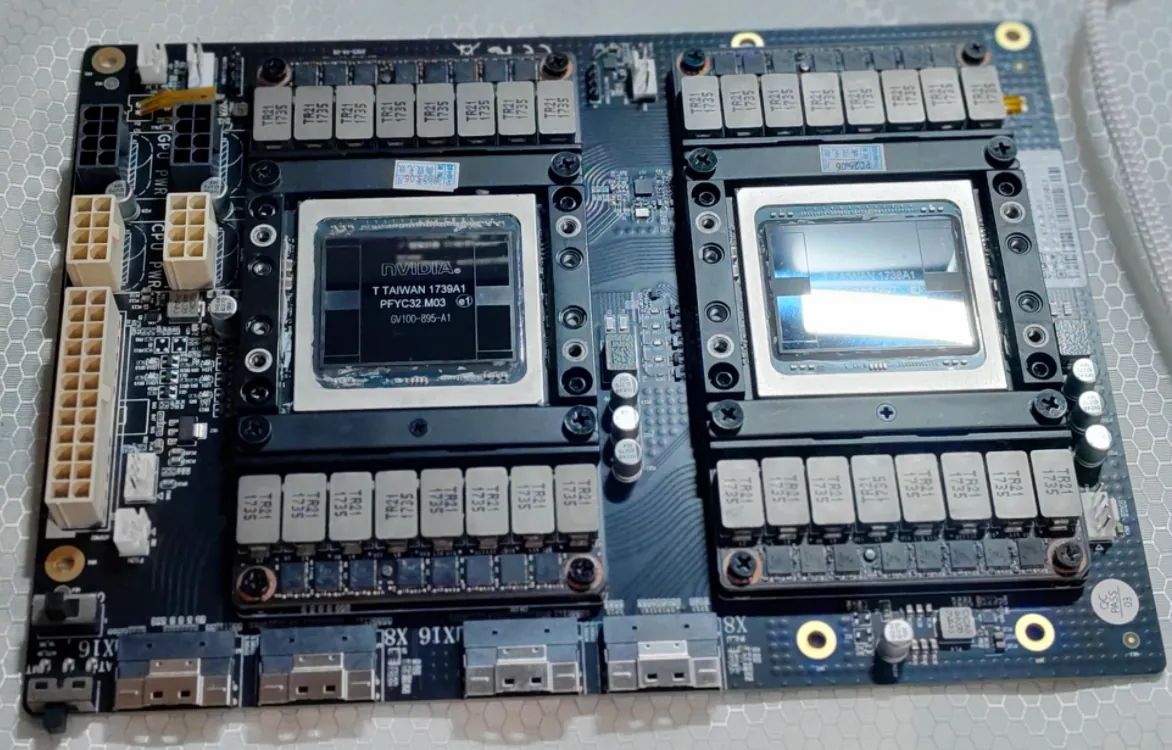
由于主板就是为 SXM2 显卡设计的,安装非常容易,拧上螺丝就行,基本属于无缝安装。
可以看到背面的螺丝情况:
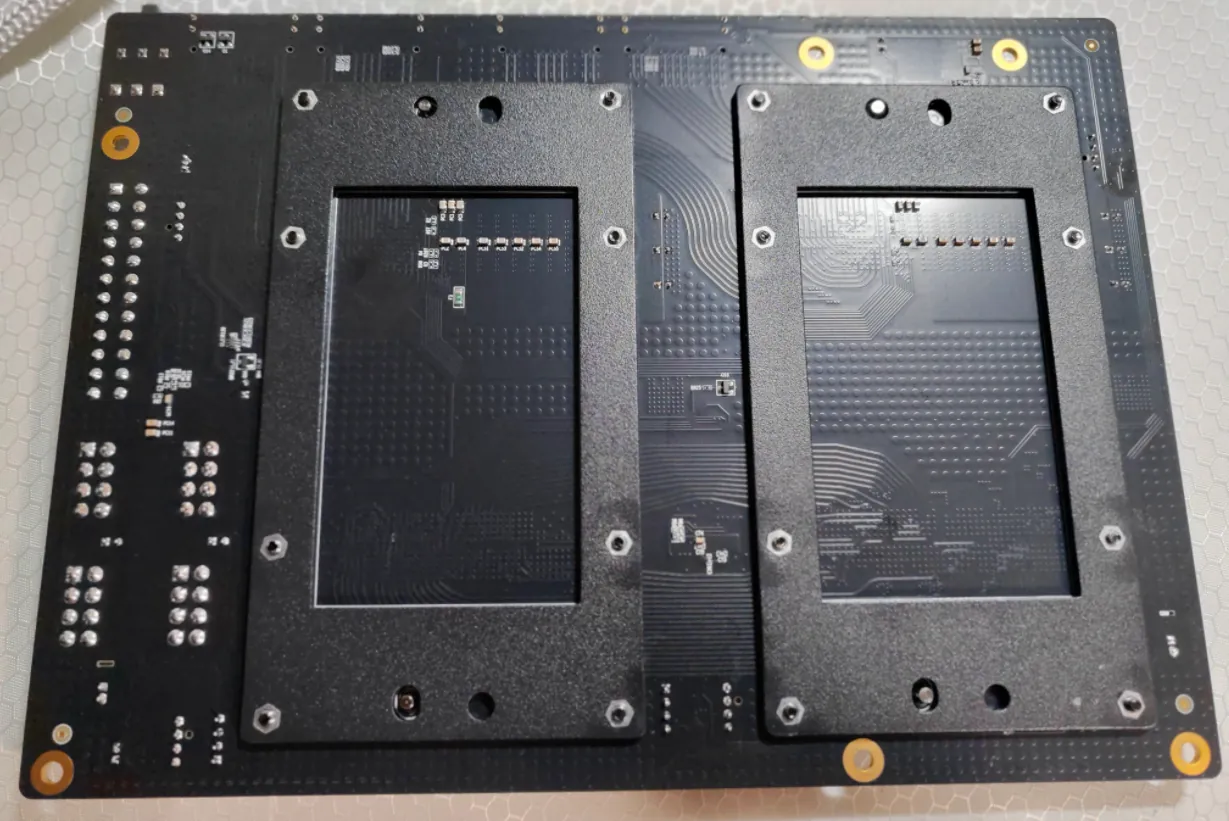
第二步:贴上散热片
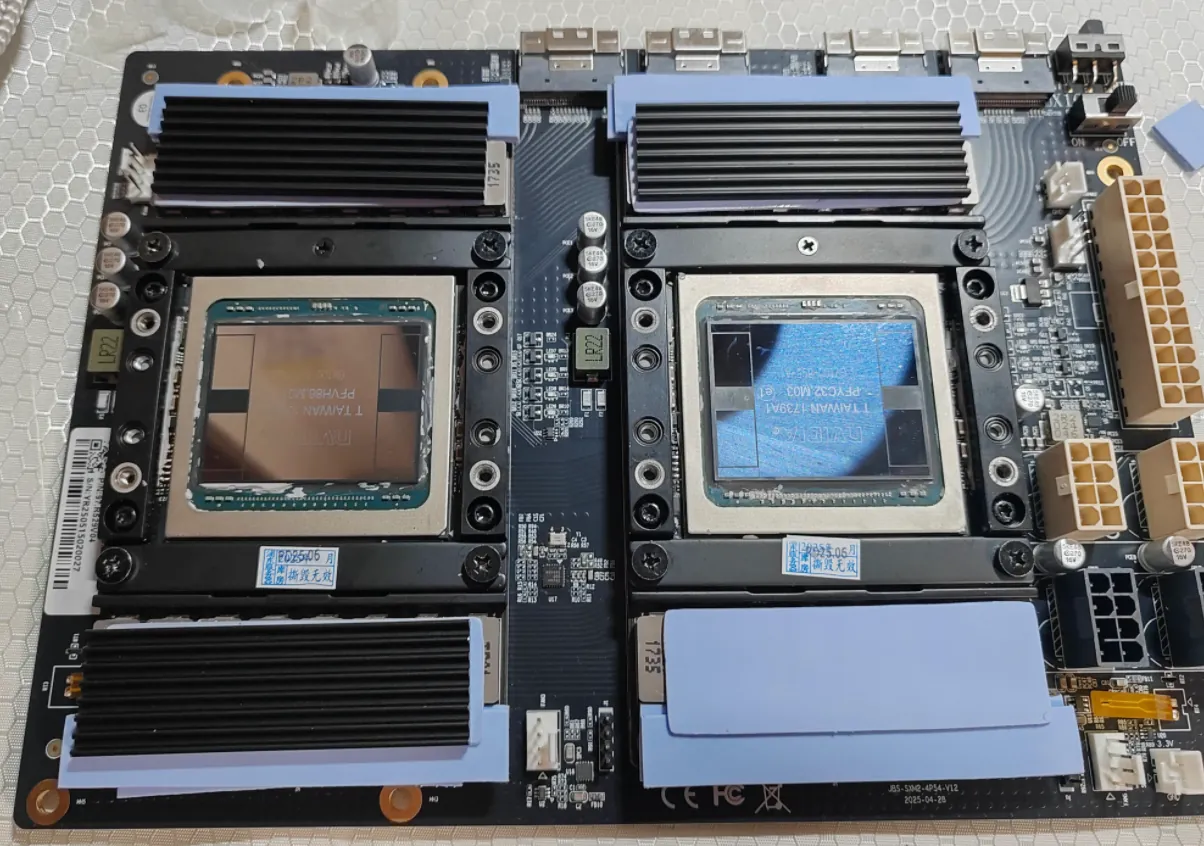
这一步是我额外加的。
主要原因是,我觉得散热器和显卡之间的间隙也应该增加一些散热措施,同时也算是给晶体管多一层保护。于是,我把硅胶片和散热片堆满显卡两边,高度与显卡基本持平。这样做之后,我心里会更踏实一些。
第三步:装上原装散热器和风扇
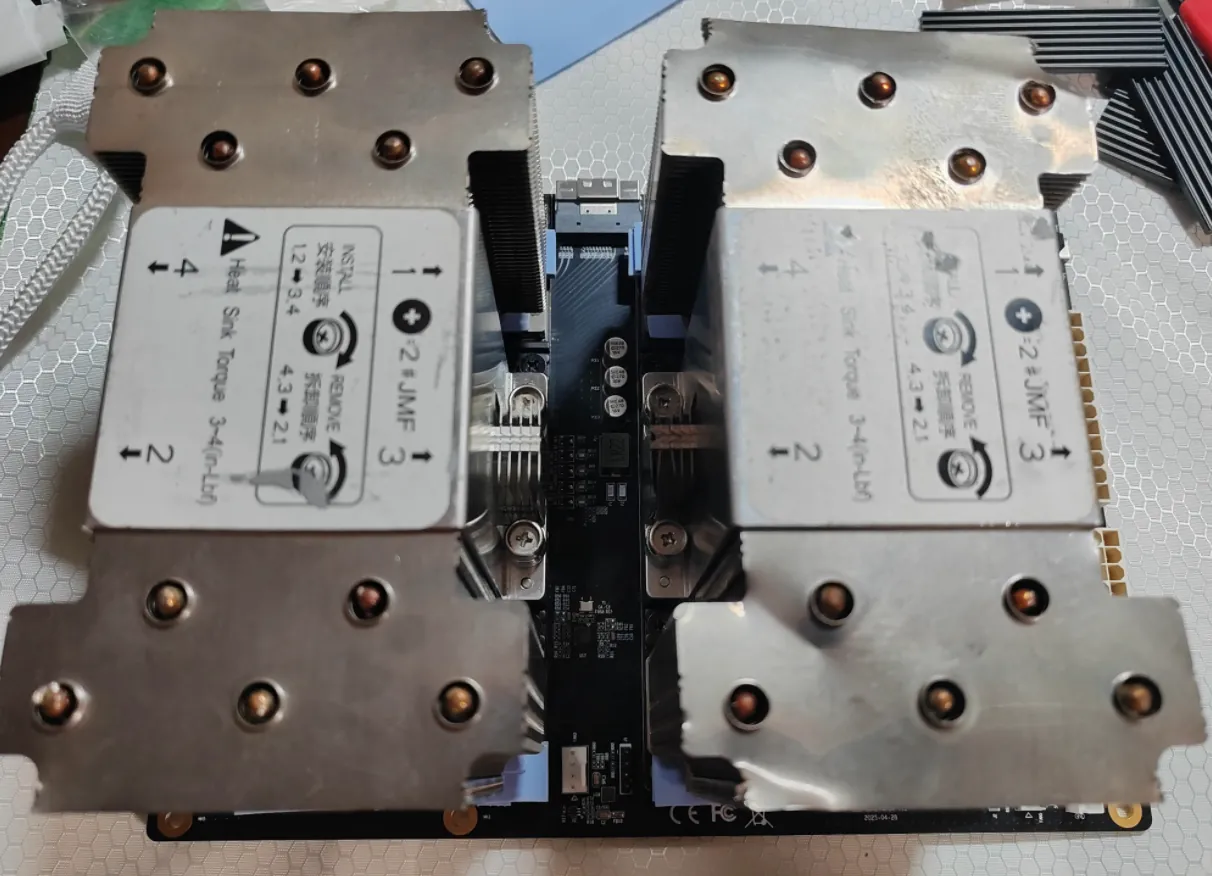
这款原装散热器确实大得吓人。我买的应该算是比较高的版本,没有选择矮款。
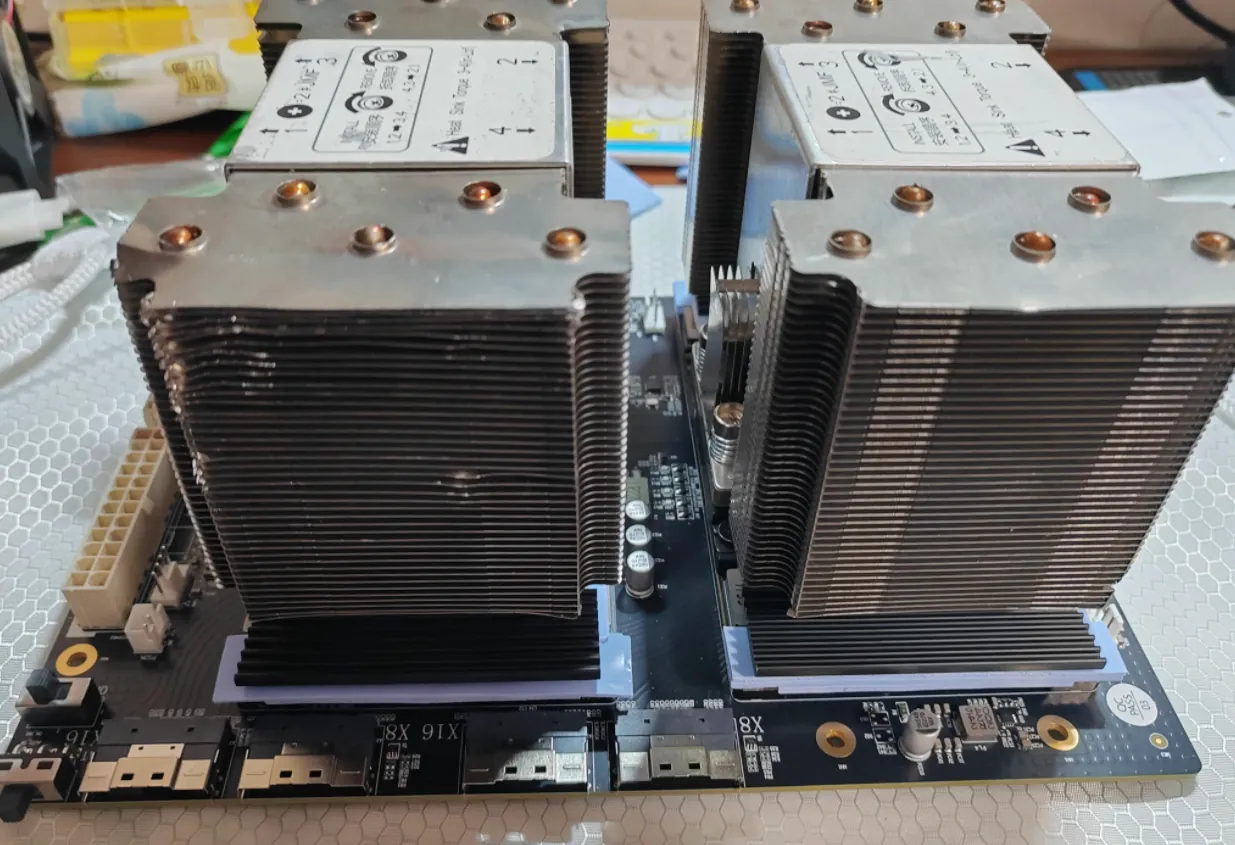
最终看起来效果还不错。主体部分基本完成,最重要的显卡也终于显露出了它巨大的一面。
不过,仅仅这样装完还不够。
如此巨大的散热器不能只依靠被动散热,还需要风扇从散热器的缝隙中送风,才能真正把热量带走。否则,热量会积在机箱内部,这显然不能接受。
所以,我在前后各安装了两个风扇,合计四个,整体散热风道也就基本清晰了。
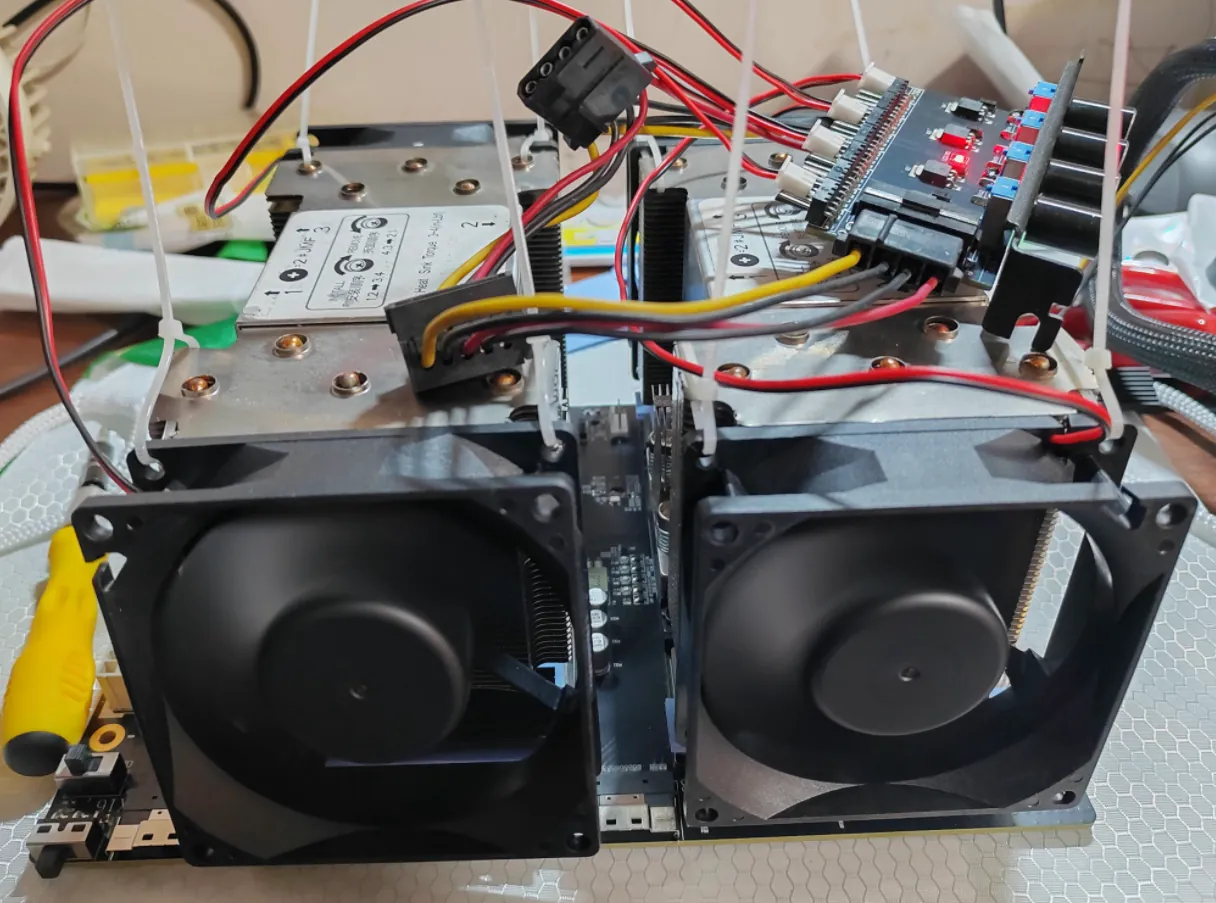
务必注意风扇的出风方向。四个风扇需要朝向同一个方向吹,这样才能真正形成有效的散热风道。
第四步:给主板接上电源
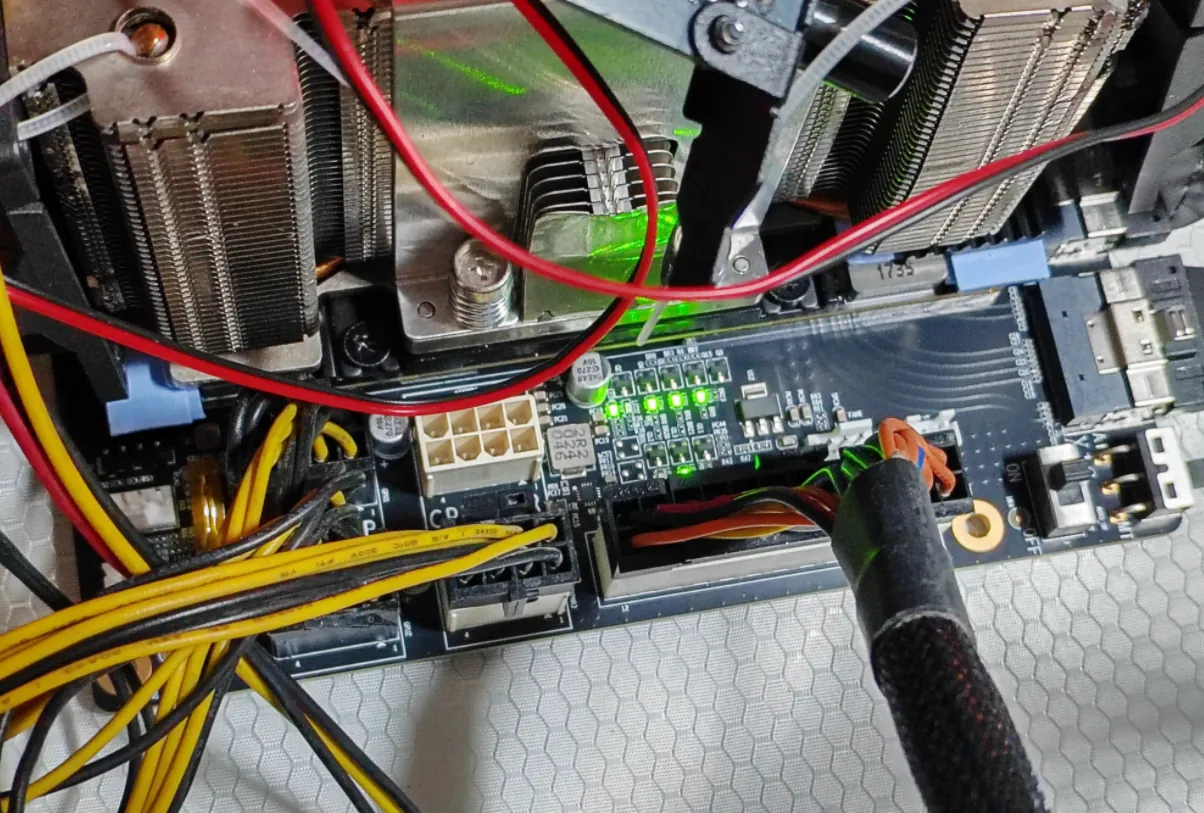
这一步需要把电源上的大电源 PIN,以及显卡所需的电源 PIN 等,全部插到主板上。
到这里,电源部分基本就完成了。
第五步:在电脑上安装转接卡
接下来是在目标电脑上的安装,需要安装两块 PCIe 卡:
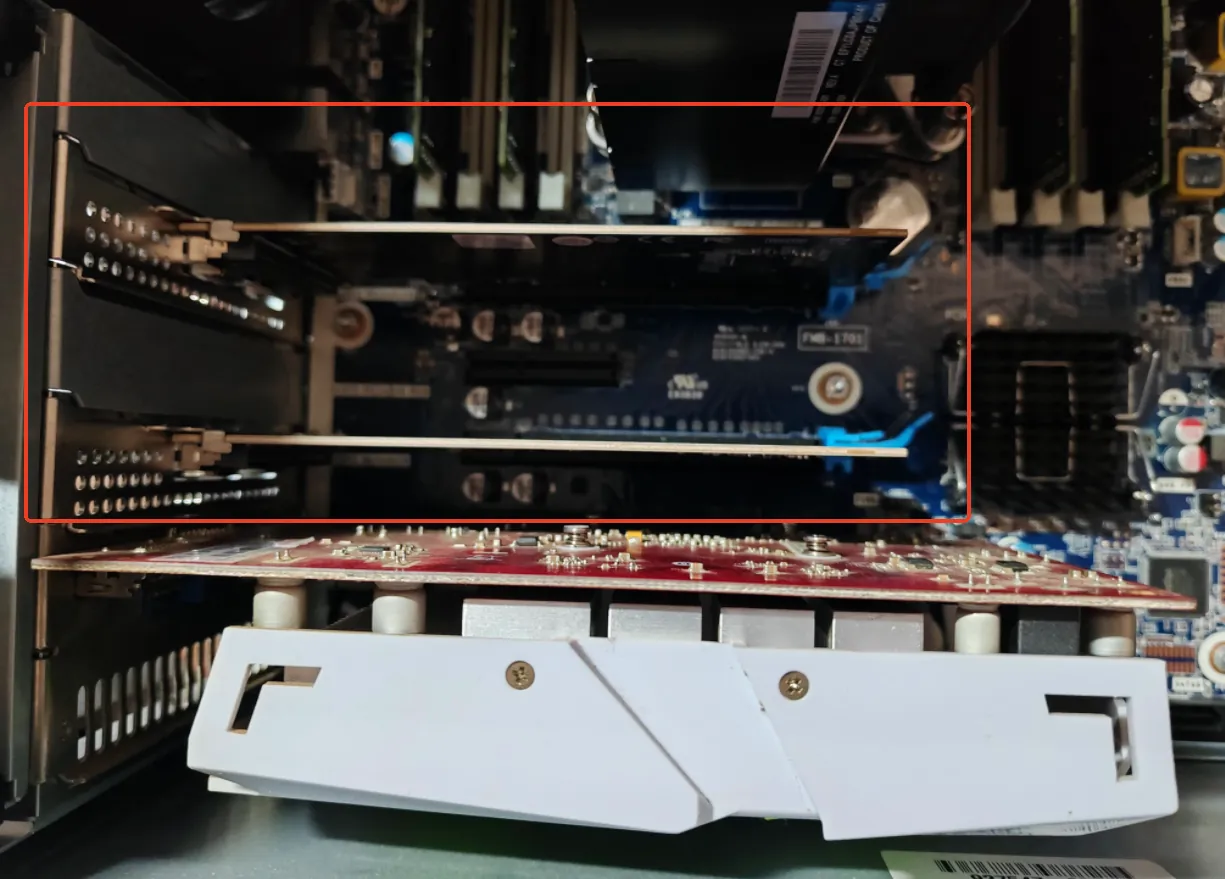
电脑主板至少需要带有两个 x16 PCIe 插槽。虽然 x8 也可以使用,但条件允许的话,尽量选择双 x16。
当然,如果 CPU 不带核显,还需要额外占用一个显卡插槽来连接显示器。
我的 Z4G4 就需要额外安装一块显卡。上图最下面那块 HD7750,就是用来连接显示器的显卡,只负责显示,不参与算力计算。我特意买了一块 AMD 显卡来承担这个任务。
第六步:接上 8654 转接线
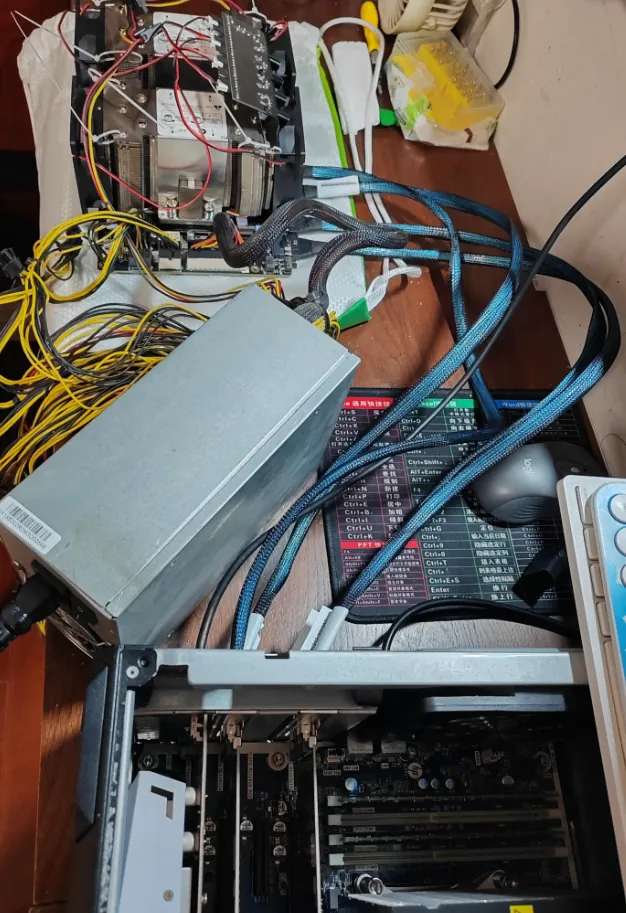
就是这些长长的线,一共四根,接起来并不复杂,但需要注意它们是交叉连接的,具体如下图:
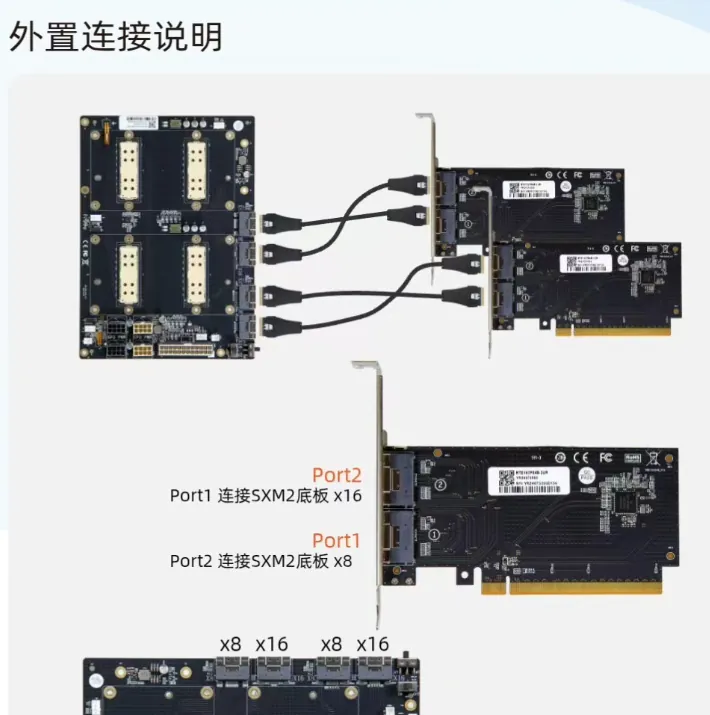
完成连接后,基本就可以上电检查了。
第七步:上电检查
正式装进机箱前,先进行一次上电检查。
注意:主板角落里有两个开关。一个用于 AT 和 MT 模式切换,另一个用于控制电源上电。
AT 模式会跟随电脑一起上电,MT 模式则是手动上电。一般建议使用 AT 模式即可。对于一台常年开机的设备来说,通常不需要频繁操作这两个开关。
先进入 Ubuntu 检查:
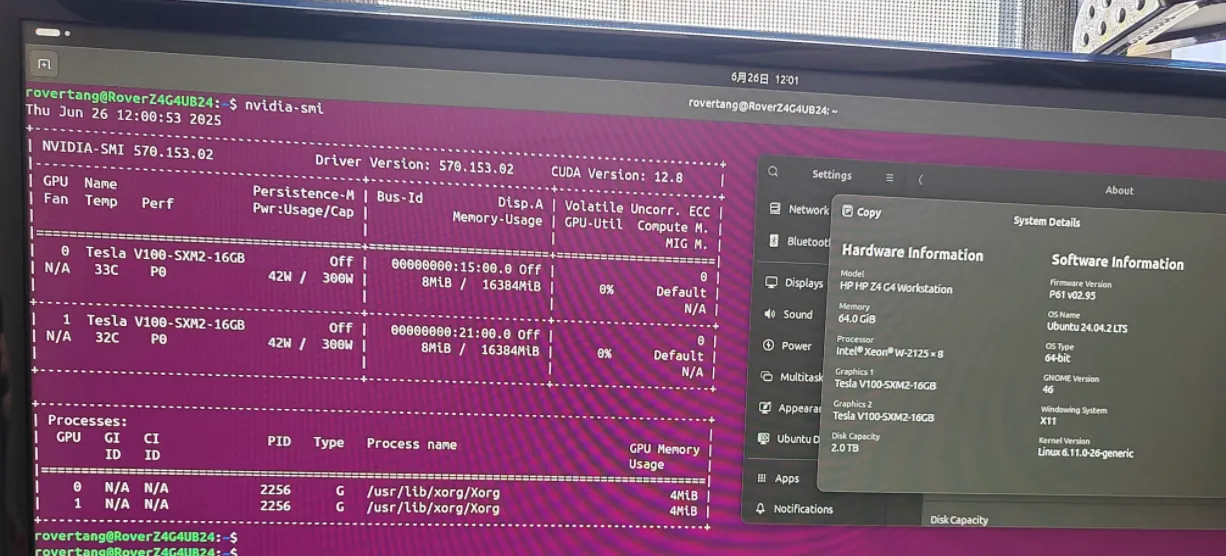
Ubuntu 24 下的驱动比较成熟,安装完成后基本就能识别。两块显卡合计 32GB 显存,已经正常显示出来了。
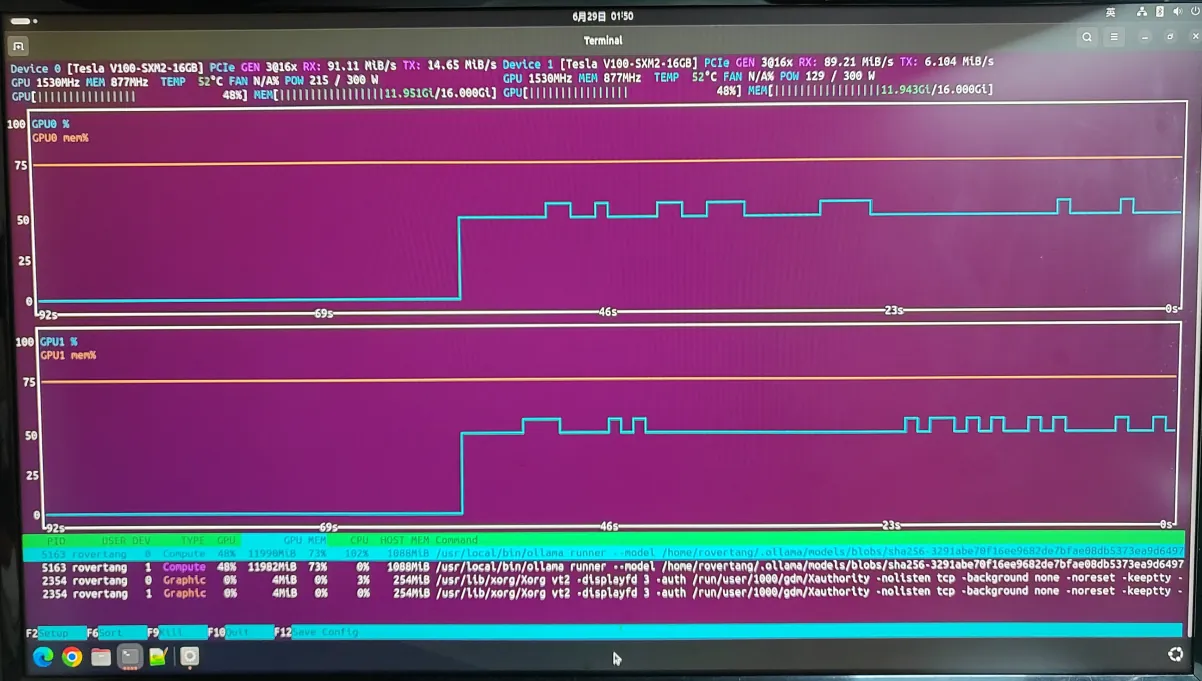
nvtop 的显示也比较正常。
接着进入 Windows 检查:
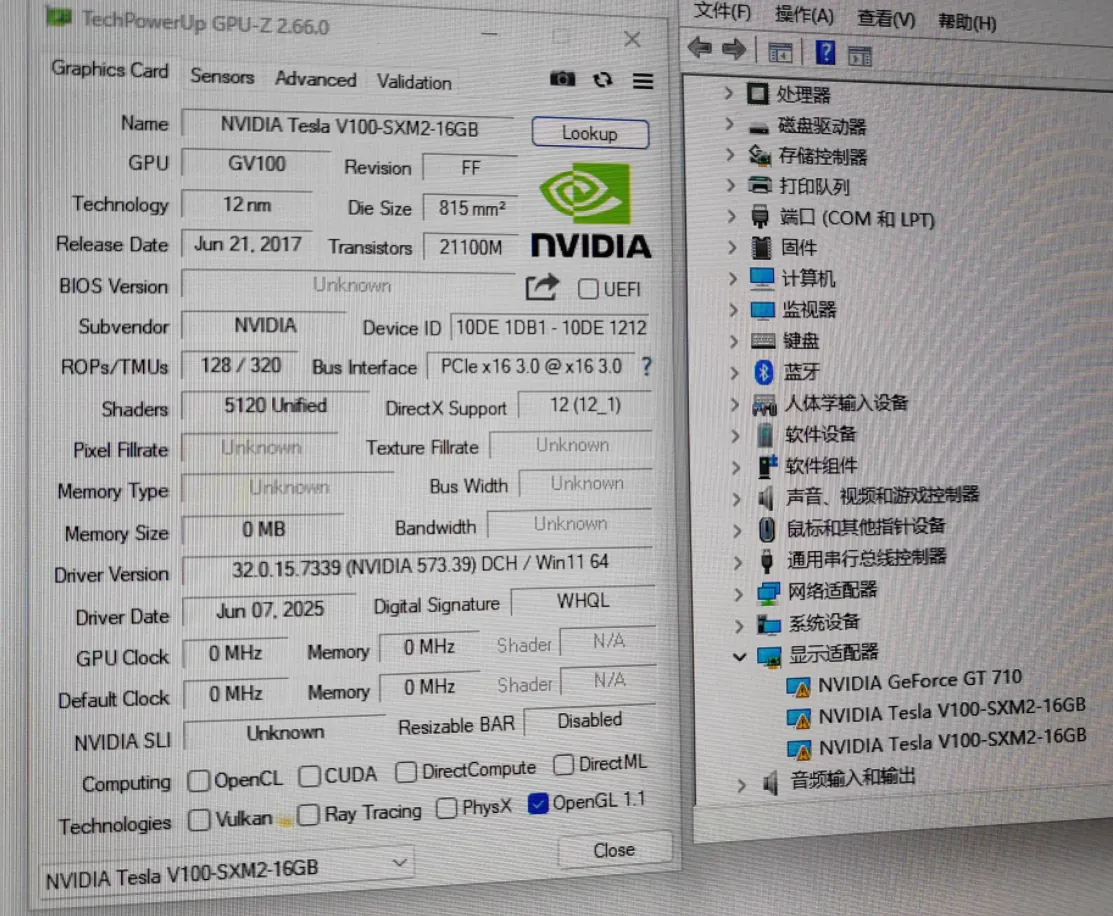
Windows 下同样能够识别两块显卡,但因为没有安装驱动,所以暂时无法直接使用。
我主要在 Ubuntu 下使用,因此没有继续处理 Windows 驱动。不过既然硬件已经能够识别,原则上应该可以安装对应驱动。
上电检查完成,32GB 显卡可以正常使用。接下来下电,准备装箱,把它真正做成一块“巨大显卡”。
第八步:将显卡装进机箱
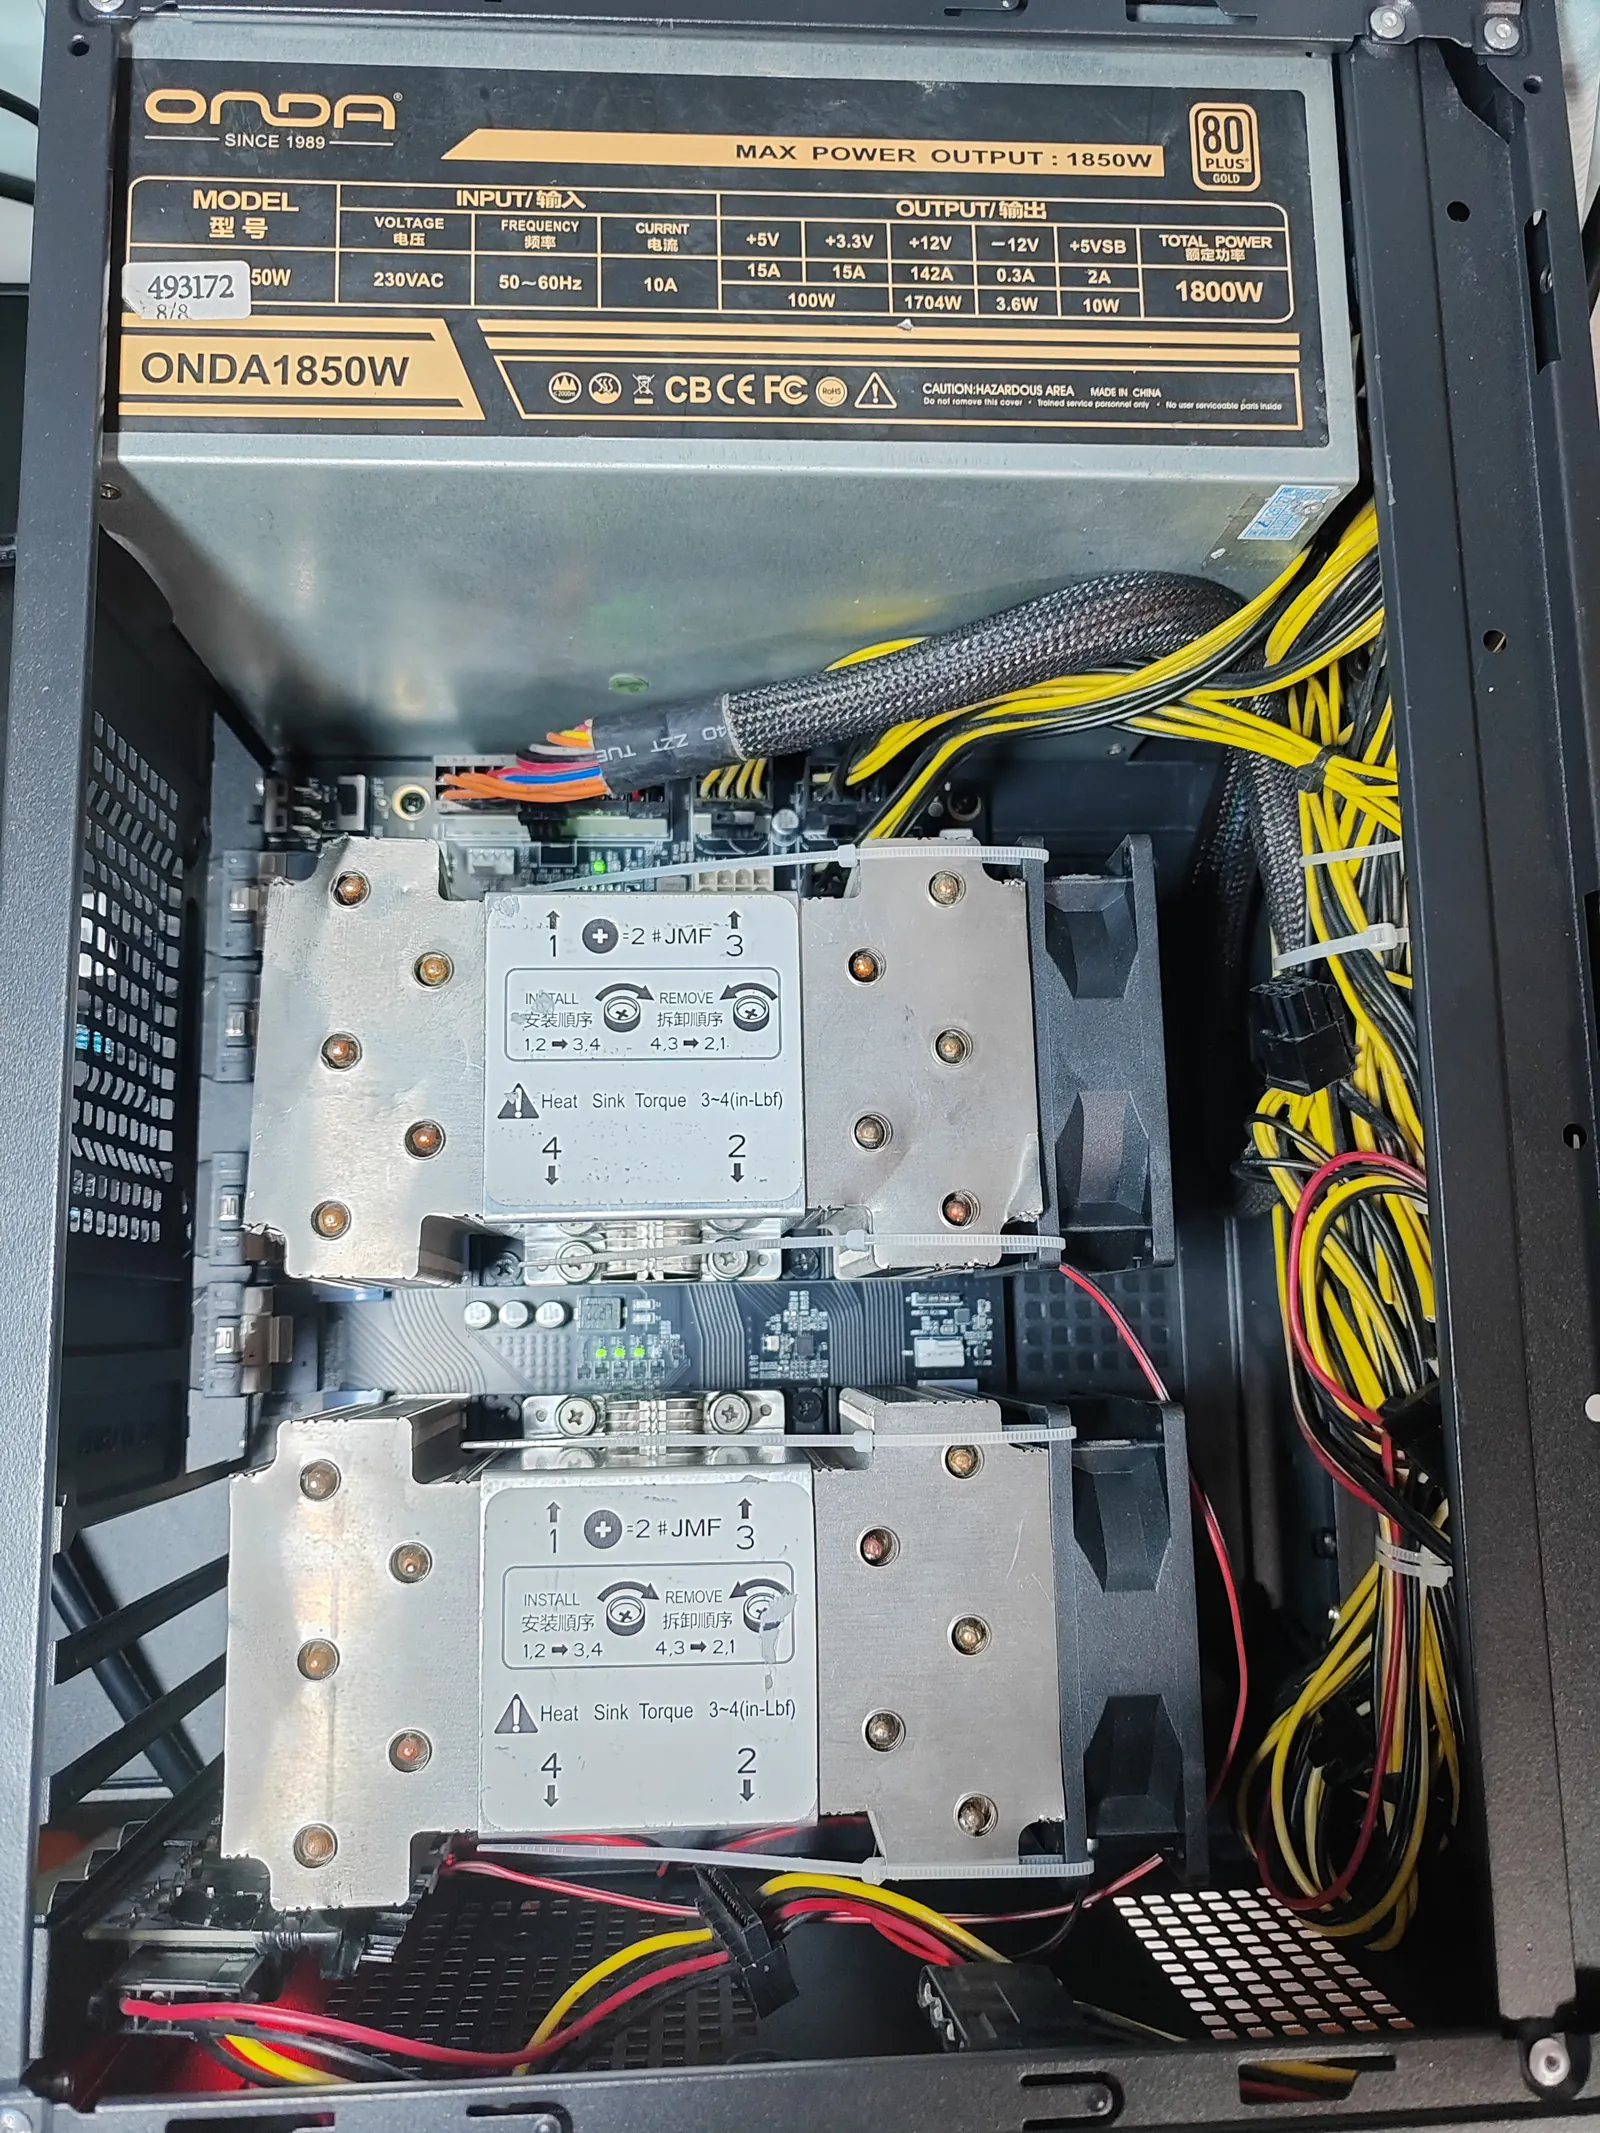
下电之后,基本就可以把显卡装进机箱了。机箱尺寸是标准的,主板直接拧螺丝固定即可。
我买的 1850W 电源有点大,供电肯定没有问题,但安装时确实比较费劲。大家后续选择电源时,务必注意电源与机箱的匹配程度,电源不宜太长。
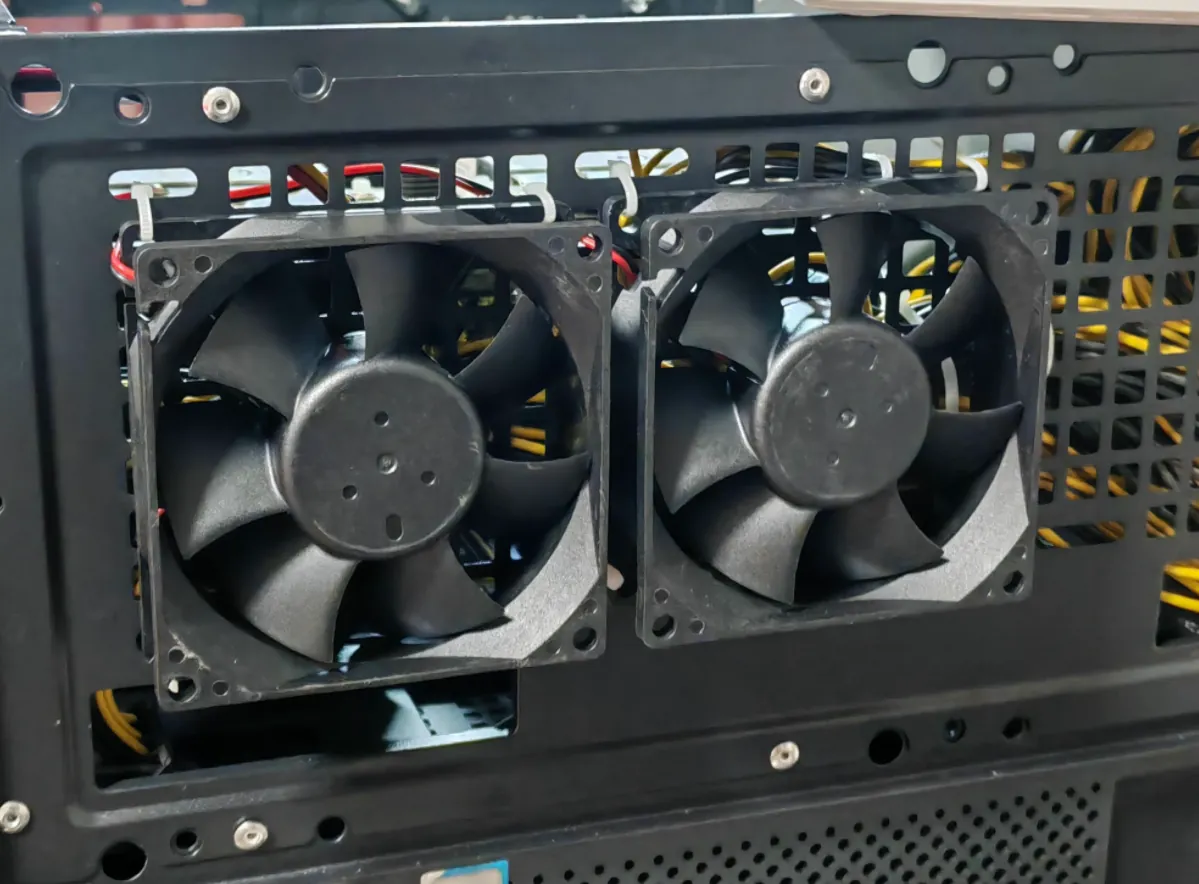
另外,由于显卡散热器尺寸较大,再加上 12×12 风扇后似乎无法完全放下,最终只能去掉靠近机箱后部的两个风扇。
不过,由于风是从内部向外吹,整体散热仍然可以接受。后续如果需要,还可以再买两个更薄的 12×12 风扇装进去。
既然两个散热器无法安装在机箱尾部,那我就把它们直接装到机箱前部,给整个机箱散热,这也是一个不错的方案:
盖上前面板之后,竟然一点也看不出来。
而且面板本身就是孔状结构,风可以直接穿透,完全没有问题。
后来我又发现机箱后面还可以再安装一个风扇,于是又在外面加装了一个。这样一来,整个风道就更加完整了:前面进风,后面排风,理论上已经足够散热。
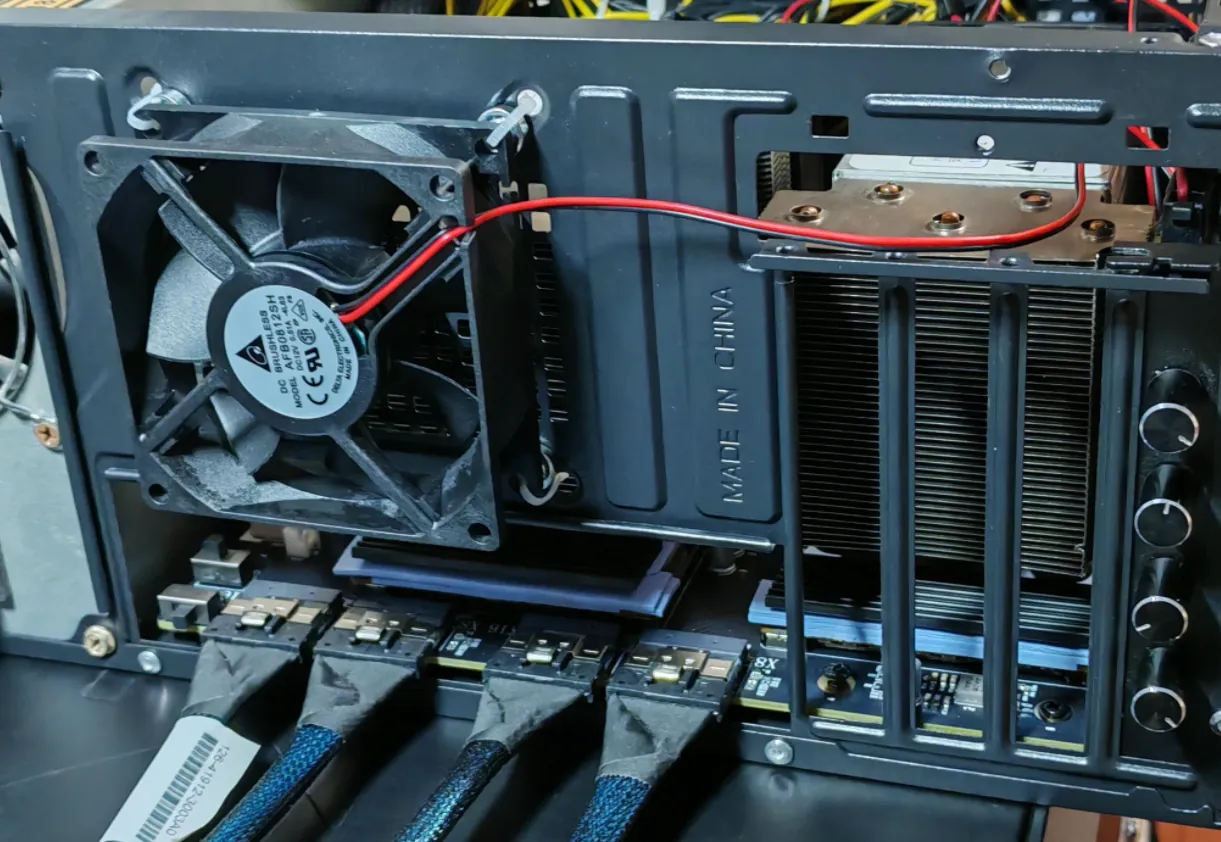
好了,至此,32GB 巨大显卡正式安装完毕。
确实有点太大了,我就不继续给大家展示了。
大模型测试
费劲组装这块 32GB 巨大显卡,最终当然是为了在本地运行大模型。
下面简单测试一下:
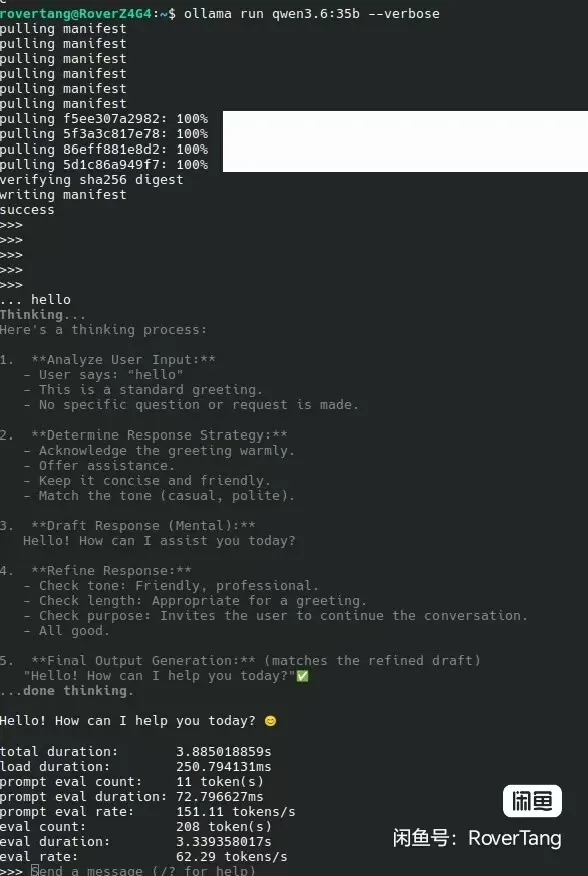
35B 的千问,能够跑出 62 tokens/s 的速度,确实让人有些惊喜。
总体来说,还是相当令人满意的。
显卡之外的考虑
成本
这块巨大显卡的购买和组装,实际是在 2025 年 618 前后完成的。
现在已经过去一年多了,我才写下这篇文章,似乎有点过时。毕竟大模型更新得实在太快,而且现在似乎也不再像以前那样流行自建大模型。
除非确实存在本地部署的必要,否则很多人可能并没有特别强烈的意愿,包括我自己在内,实际使用场景也不算太多。
但是,不到 100 元/GB 的成本,大家是否愿意接受呢?
现在无论是购买一块 32GB 显存的显卡,还是租用一台拥有 32GB 显存的服务器,价格都不算便宜。如果自己拥有一块 32GB 显存的显卡,成本不到 100 元/GB,是否值得?
这个问题,可能每个人都会有不同答案。
我个人认为,如果确实有自建大模型的需求,这块显卡是值得的。
如果是为了进行大模型研究,需要反复折腾各种模型,那么用不高的价格获得 32GB 显存,自己动手玩一玩,同样是值得的。
不知道屏幕前的你怎么看?欢迎与我联系交流。
电费
上面说的是一次性的显性成本,隐性成本同样不小,这就是电费。
显卡的耗电量,大家应该都有所了解。这块巨大显卡在运行大模型时,大概会消耗多少电呢?
我抓拍了一次运行大模型时的较高功率值:
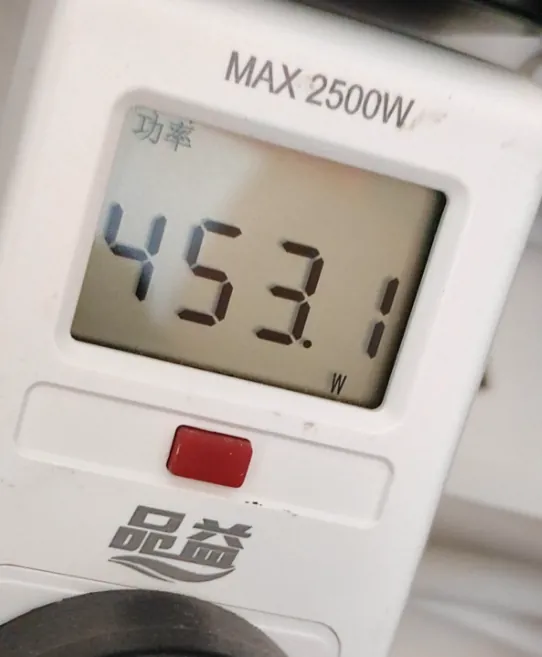
这意味着,如果一直运行大模型,大约两三个小时就要消耗一度电。一天下来,可能要消耗 10 度电左右。
按照电费计算,一天少则 5 元,多则 10 元。
这样的成本放在公司里可能问题不大,但对于个人长时间运行来说,确实需要认真考虑。
是否会被这样的电费吓退,也许同样取决于每个人的使用场景。
模型的选择
基于当前的模型发展情况,对于本地 32GB 显存的设备来说,什么样的模型比较合适?
一般来说,27B~36B 左右的模型比较合适,17B 左右的 Flash 模型也是不错的选择。
虽然模型进步得非常快,每一次更新都在不断超越上一代,但模型本身也在持续变大,小 B 模型越来越少,个人自行部署的可能性也越来越低。
不过,我还是很怀念过年前后的那段时间。
那时候我正在研究“龙虾”,也就是 openclaw。当时使用的是 glm-4.7-flash 模型,不仅速度快,智能化程度也完全够用。
所以,我个人比较感兴趣的模型可能是下面这些:
glm-4.7-flash:q4_K_M
qwen3.8:27b
gemma4:31b
这些模型的显存占用都在 20GB 左右,剩余显存正好可以用于缓存,整体上会相对宽裕一些。
预计我会按照这个方向进行部署。
屏幕前的你,对于 32GB 显存的设备有什么模型推荐呢?欢迎留言交流。
好了,这块真正巨大的显卡就介绍到这里。
整个过程体现了罗孚超凡的组装能力。
当然,这是开玩笑的。
不过,罗孚确实认为,部署 20GB 左右显存占用的模型,自己 DIY 玩一玩,还是很有意思的。
你是否也对这种低成本、高显存的显卡感兴趣?
欢迎和我一起交流。